
Prism总协调
棱
统一接单、分发任务,再收回结果。
FIELD REPORT · HERMESAGENT · 2026
7 个 Agent 的 真实交付与失效记录
我把 7 个 Agent 接进飞书。它们完成过网站重做和 Wiki 整理,也在消息路由、会话隔离与定时调度中失效。这是一份搭建、交付和排错记录。
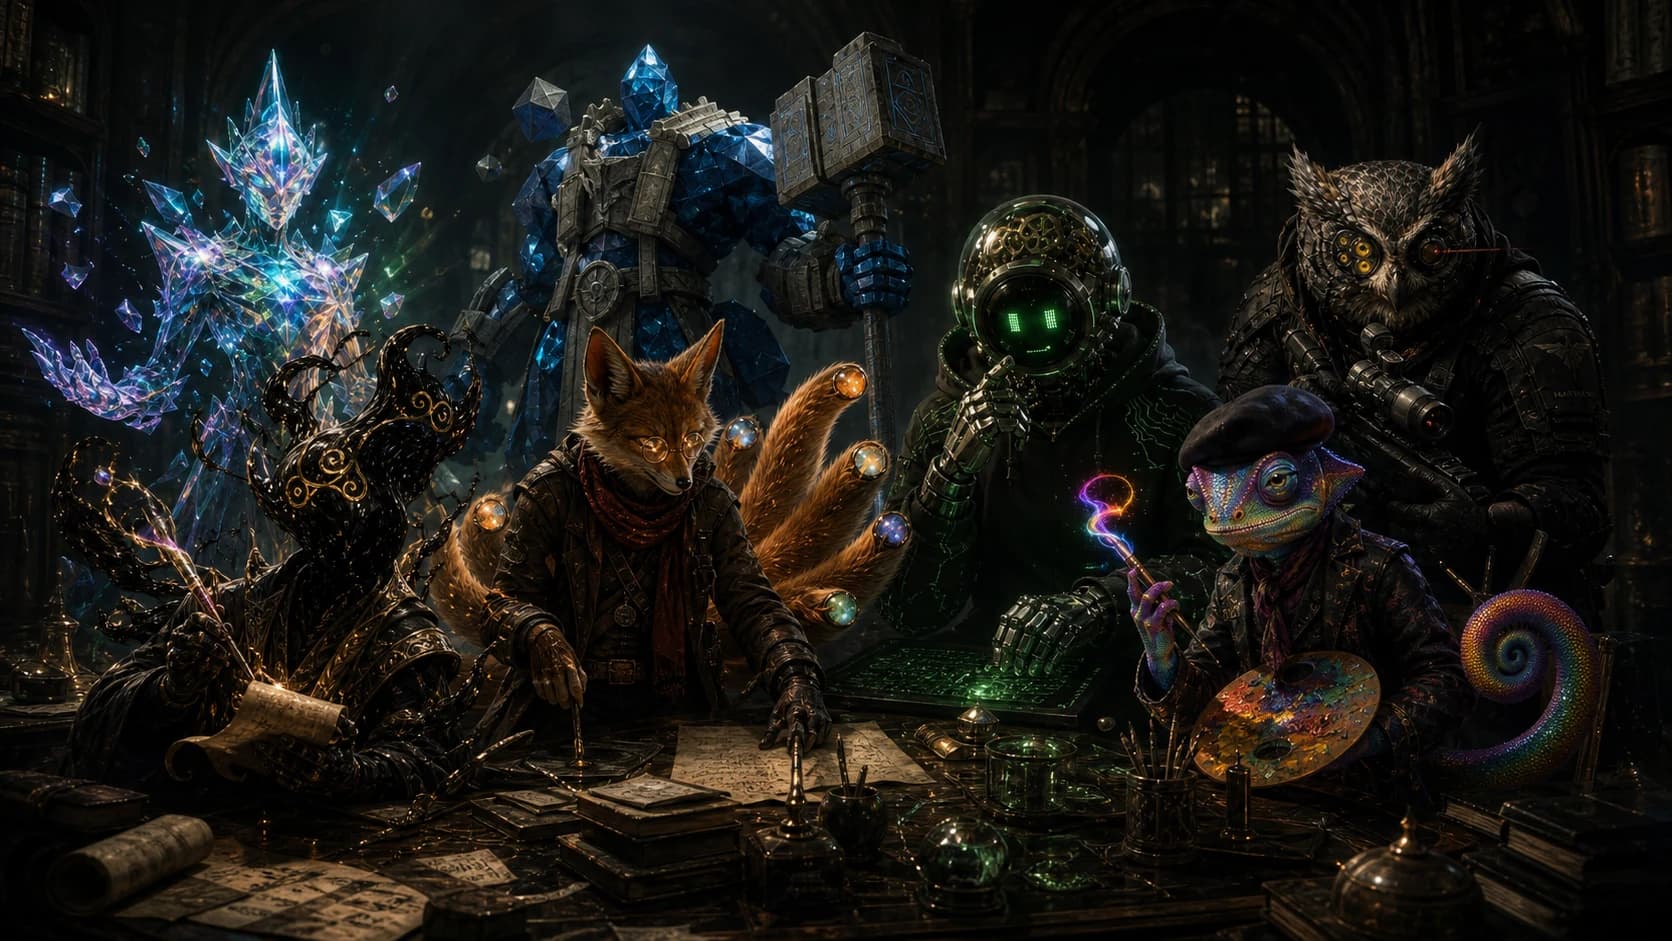
THE SEVEN ROLES
统一接单、分发任务,再收回结果。

先定约束,再把目标拆成能交付的任务。

实现和修复代码,并跑完必要验证。

按验收条件测试,把失败留成可复现记录。

整理决定、改动和使用方法。

查资料、交叉核对,再给出可用结论。

负责界面方向、交互和前端视觉落地。
我原来以为,多 Agent 协作就像组一个项目群:安排一个项目经理,再放进程序、测试、文档、调研和设计,让它们按职责接力。
真正接进飞书后,第一条群消息就让几个 Bot 同时抢答。后来又出现结果从群聊跑到私聊、工具没有执行却声称完成、定时调度把任务状态判断错等问题。
同一批 Agent 也确实完成了两件实际工作:一版网站改造,以及一次大规模 Wiki 清理。
这段经历最后说明了一件很具体的事:Agent 能不能独立完成工作,和多个 Agent 能不能稳定协作,是两个难度完全不同的问题。
这篇文章会先用几个容易代入的任务讲清常见结构,再回到万象工作室,看两次交付为什么成功,11 条自动信号为什么从早期 4 条成功回传,走到最终一轮 0 条返回。
🔷 这次实验留下的结果
7 个 Agent:1 个协调者 Prism + 6 个专业角色网站交付:7 张角色图、7 张特效图,处理后随页面上线
Wiki 交付:顶层目录 13 → 9,游离文档 213 → 0,零链接文档 85 → 0
自动信号测试:共发送 11 条,早期 4 条返回
DONE,最终一轮 0 条返回
多 Agent 的名词很多,真正需要理解的只有四种关系。
你把整件事交给一个 Agent。它自己读资料、调用工具、整理结果,再直接回复你。
适合范围集中、一次就能完成的事情。例如:
“把这篇 3000 字文章改得更好读,保留原观点,删掉重复内容。”
输入只有一篇文章,输出也只有一篇改稿。多安排几个角色,只会多出交接和合并成本。
这就是单 Agent + 工具。
你把需求交给一个总负责人。总负责人自己不一定完成所有细节,它会找几个专业 Agent 分头处理,再把结果合成一份最终答案。
例如:
“调研 10 款同类产品,比较价格、核心功能和用户评价,最后告诉我最值得买哪三款。”
总负责人可以这样拆:
用户始终只和总负责人沟通,也只收到一份最终结论。
这就是主管调用专业 Agent。OpenAI Agents SDK 中的 “agents as tools” 属于这一类:专业 Agent 完成有边界的子任务,原来的主管继续负责用户会话和最终答复。官方说明
有些事情不需要总负责人继续汇总。入口判断完类型后,直接把后续对话交给专业 Agent。
最容易理解的场景是客服:
你说:“这笔订单我要退款。”
入口 Agent 先确认这是退款问题,然后把会话转给退款 Agent。接下来订单号、退款原因和进度都由退款 Agent 继续问,你不会每说一句话都回到入口重新分配。
这就是转交(Handoff)。OpenAI 的文档用订单、退款、账户等客服场景解释这种结构:选中的专业 Agent 接管后续会话。官方说明
有些任务有固定顺序,前一步没有通过,后一步就不能开始。
例如:
“修复登录按钮没反应的问题,补回归测试,通过后部署到测试环境。”
更稳的执行方式是:
复现问题
    ↓
修改代码
    ↓
运行测试
    ↓
测试通过?── 否 → 退回修改
    ↓ 是
部署测试环境
    ↓
检查页面可用
程序负责顺序、退回、重试和状态保存。Agent 负责每个步骤里真正需要理解的工作,例如分析报错、修改代码或解释测试失败。
这就是程序化工作流 + Agent 节点。LangGraph 将工作流定义为预先确定的代码路径,CrewAI Flows 也把状态、事件和执行顺序交给流程层管理。LangGraph 说明 · CrewAI Flows
| 你的任务 | 更合适的结构 |
|---|---|
| 一次性完成,只有一个主要产物 | 一个 Agent 从头做到尾 |
| 可以分成几个互不依赖的部分,最后需要一份总结果 | 主管调用多个专业 Agent |
| 入口只负责分流,后续由某个专家持续和用户沟通 | Handoff 转交 |
| 有固定步骤、审核、退回、重试、定时执行或发布动作 | 程序化工作流 + Agent 节点 |
Anthropic 在 Agent 工程总结中也建议从能够解决问题的最简单结构开始,确认单 Agent 已经成为瓶颈以后,再增加分工与编排。Building Effective Agents
万象工作室建立在 HermesAgent 上,飞书是统一入口。
Prism 像项目经理,负责接收和分配任务;砌匠处理方案,铸码写代码,鹰眼检查结果,墨客整理文档,猎犬查资料,画匠处理视觉。
同时,agentmemory 既保存长期记忆,也承担任务信号池;cron Agent 定时查看共享池,再判断应该唤醒谁。
Prism 承担主管角色,专业角色像子 Agent,信号池承担交接,cron Agent 又在扮演工作流引擎。
问题逐渐集中到同一个地方:任务归谁、现在做到哪一步、工具是否执行、下一步叫谁,这些本该是明确字段的状态,被写进了自然语言,再交给模型重新理解。
万象工作室自己的展示页,成了画匠参与的一次实际任务。
旧版页面使用一段 480vh 的传送门式滚动。创意很强,阅读时却要持续滚动很长距离。改造时,页面换成七个角色的 CG 依次进入画面。
画匠 Pixel 生成了 7 张角色图和 7 张特效图,随后完成透明底处理、WebP 压缩、页面接入和 Vercel Production 部署。
这项任务很好验收:
| 项目 | 内容 |
|---|---|
| 输入 | 旧页面、七个角色设定、现有站点工程 |
| 负责人 | 画匠 |
| 交付物 | 14 张站点资源、页面改动、线上版本 |
| 完成标准 | 资源正确显示、透明背景正常、页面已部署且可访问 |
Agent 写了什么总结并不关键。打开页面能否看到正确结果,才是最终判断。
墨客 Quill 负责整理长期堆积的个人 Wiki。
其中有 213 篇“游离文档”:文件真实存在,却没有任何目录或入口页面指向它们。另有 85 篇“零链接文档”:既没有链接到其他内容,也没有被其他内容链接,几乎无法从知识库中被自然找到。
墨客把 15 篇 OM 知识库内容重新放入 profile/、领域目录等位置,并和原有资料库合并。整理结束后:
过程中还找到一个具体解析问题:某份编剧文件用了 167 个 --- 作为分隔线,解析器把它们误认为 frontmatter 边界,导致文档结构异常。这个问题也被一并修复。
这项任务同样有一个清楚的任务单:
任务:整理个人 Wiki
负责人:墨客
输入:OM 知识库 15 篇 + 原有资料库
完成标准:游离文档 = 0;零链接文档 = 0;核心覆盖率 = 100%
证据:整理前后统计、目录结构、异常文件修复记录
结果去向:人工检查后写回 Wiki
这两次成功都没有依赖七个角色长时间自动接力。它们更像“把一个边界明确的子任务,交给一个专业 Agent 完成”。
为了让 Agent 主动交接,Prism 会向 agentmemory 写入任务信号。目标 Agent 读取以后执行,再写回 DONE、结果和状态。
早期测试中,铸码连续处理了 4 条信号,结果也成功回到飞书。
当天晚些时候,最终一轮测试变成 0 条 DONE。
这次失效并非某一个 Prompt 写坏了。整条链路连续暴露了四类问题。
require_mention 配置不当时,专业 Bot 会接收群里的全部消息。一句话发出去,几个角色同时认为自己应该开始工作。
后来改成只有被明确 @ 才响应,由 Prism 统一接单。
群聊里的任务曾被发到私聊。排查发现,Prism 的上下文从群聊 Session 漂移到了私聊 Session。
一项任务如果没有明确保存“结果回到哪个群、哪个线程、哪个用户”,模型只能根据对话猜。
有些 Agent 把 send_message 工具调用写成一段文字,看起来像调用了工具,实际没有执行 API。
后来 Prism 还两次声称收到了用户截图,真实会话里并没有图片。
因此,“我已经发送”“我已经看到”“我已经完成”只能算模型回复。文件变化、工具回执、测试结果和可访问页面才算证据。
cron Agent 需要定时读取任务池,判断某项工作是否处理、该唤醒谁、是否需要重试。
这些判断没有稳定字段,cron Agent 只能阅读自然语言记录。有时它没有调用要求的 MCP,有时把未完成任务判断为完成,后面的角色随即失去可靠依据。
最终的问题很清楚:执行任务的模型,同时还在负责记账、排班和判定完成。
一条任务至少要保存下面这些内容:
| 字段 | 解决的问题 | 例子 |
|---|---|---|
| task_id | 区分不同任务,避免把两件事混在一起 | wiki-cleanup-2026-06 |
| owner | 谁有权继续修改 | quill |
| status | 当前在等待、执行、检查还是完成 | review |
| session_id | 结果应该回到哪个会话 | 飞书群 Session |
| acceptance | 怎样才算完成 | 游离文档和零链接文档均为 0 |
| evidence | 用什么证明已经完成 | 统计结果、变更清单、测试输出 |
| attempt | 控制重试,避免无限循环 | 1 / 3 |
| next | 下一步由谁处理 | human_review |
Agent 可以建议把状态改成完成,程序需要先检查必填字段和证据,再真正写入 done。
我会保留飞书入口和专业角色,但把中间层做成一条普通的软件工作流。
落地时我会坚持六条规则:
LangGraph、CrewAI Flows 和 OpenAI Agents SDK 的写法不同,方向却很接近:模型处理理解与生成,程序负责状态、路由、持久化和恢复。
万象工作室没有变成一家可以自行运转的 AI 公司。它证明了两件更实际的事。
第一,专业 Agent 在输入有限、交付物明确、结果可检查时,确实能完成有价值的工作。网站改版和 Wiki 清理都属于这一类。
第二,多 Agent 协作的主要工程量在角色之外。消息归属、任务状态、完成证据、失败重试和中断恢复没有解决时,多放几个角色只会增加更多误解机会。
后来我把其中两个问题继续拆成独立工具:Hermes CC Bridge 用来追踪 Claude Code 的工具调用、完成信号和会话恢复;Agent Board Kit 用来记录多个 Coding Agent 的任务归属、修改范围和文件冲突。
这次实验真正留下的经验可以压缩成一句话:
先把任务做成一张能检查、能恢复的任务单,再考虑让几个 Agent 一起工作。